LLMOとは何か?初心者にも分かる完全ガイド【2026年版】
目次
この記事の結論:LLMOを理解する5つのポイント
1. LLMOとは「生成AIに引用されるための最適化」のこと — ChatGPTやGeminiなどのAIが回答を生成する際に、あなたのサイトのコンテンツを参照・引用してもらうための取り組み全般を指します。
2. SEO・GEO・AIOとは目的が少し違う — 従来のSEOが検索順位やクリック数を目標とするのに対して、LLMOはAIの回答内での「引用・ブランド露出」を直接の成果指標とします。ただし、これらは競合せず補完関係にあります。
3. 鍵はRAG(検索拡張生成)の仕組みを理解すること — AIはすべてをゼロから生成しているわけではなく、関連するウェブコンテンツを検索して参照します。この「検索して参照」のプロセスに最適化するのがLLMOの核心です。
4. 今すぐできることから始められる — 高額な技術投資は最初は不要です。クローラーの通過確認、FAQコンテンツの整備、著者情報の明記など、無料または低コストで始められる施策があります。構造化データ(JSON-LD)も低コストですが、AI引用を増やす効果は確認されていないため優先度は下がります(後述の「技術・設定」で詳しく扱います)。
5. 効果は「AI引用数」と「AI経由のCVR」で測る — AI由来のトラフィックは質が高く、コンバージョン率が従来の検索経由より高い傾向があるという調査報告もあります。
以下では、各テーマを順に解説します。要点を動画でも解説しています。
LLMOとは?SEO・GEO・AIOとの違いと、私が推奨から外した2つの施策
1. LLMOとは何か?(定義)
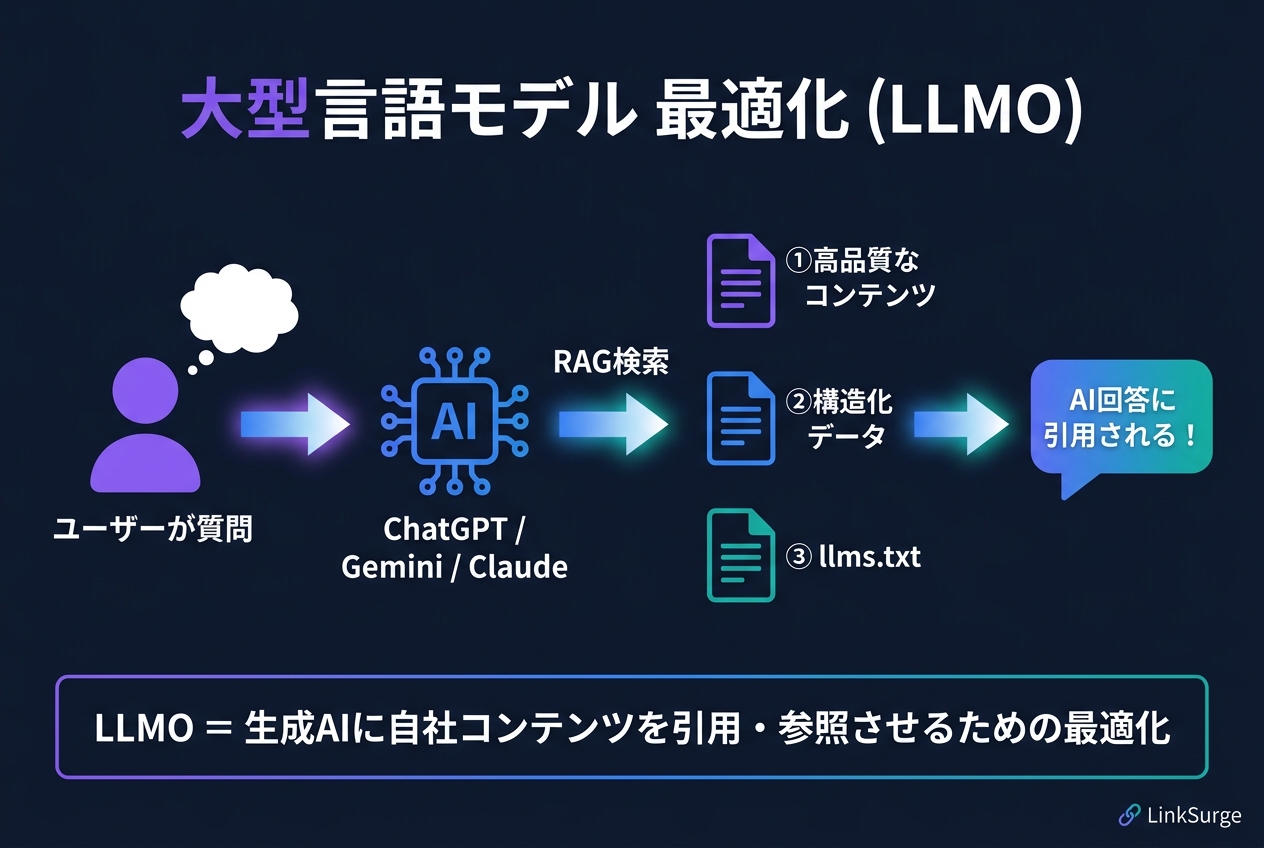
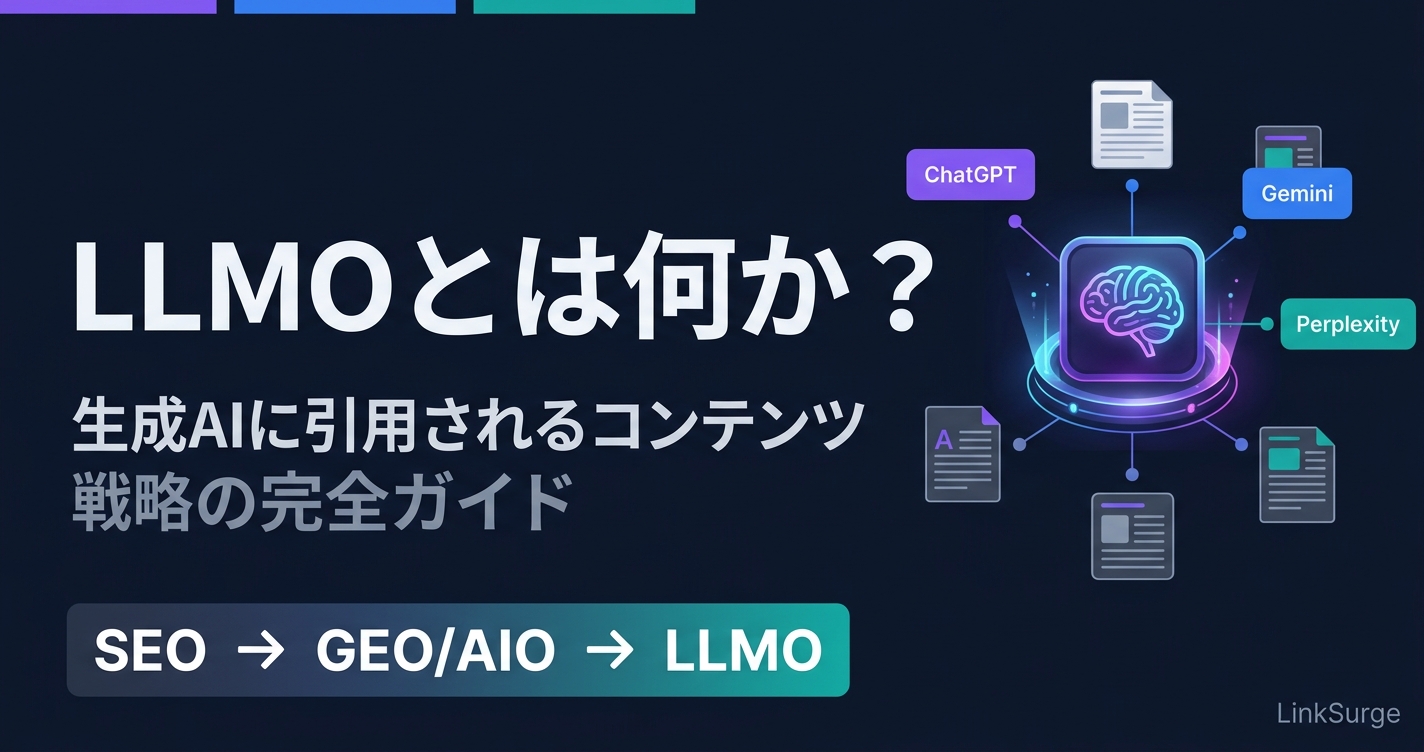
LLMO(Large Language Model Optimization) とは、ChatGPT、Google Gemini、Claude、Perplexityなどの生成AI(大規模言語モデル)が回答を作成する際に、あなたのウェブサイトのコンテンツを参照・引用してもらえるよう、コンテンツや技術環境を最適化する取り組みのことです。
少し前まで、ウェブマーケターが気にすべき「最適化」はほぼSEO(Search Engine Optimization)一択でした。ところが今は、多くのユーザーがGoogleで検索するのではなく、ChatGPTやGeminiに直接質問するようになっています。そこで必要になったのがLLMOという考え方です。
率直に言って、私がLLMOを初めて聞いたとき「また新しいバズワードか」と思いました。でも調べていくうちに、これはSEOに取って代わるものではなく、SEOを補完・拡張する実務的な概念だと理解できました。
LLMOが目指すもの
LLMOが目指すのは「AIの回答内での引用・ブランド露出」です。ユーザーがAIチャットに質問したとき、AIの回答の中に「〇〇社によると...」「参照:linksurge.jp」といった形で自社コンテンツが登場する状態を作ることが目的です。
たとえ検索順位が変わらなくても、AIが自社コンテンツを引用してくれれば、ユーザーに届くチャンスが増えます。これがLLMOという考え方の本質です。
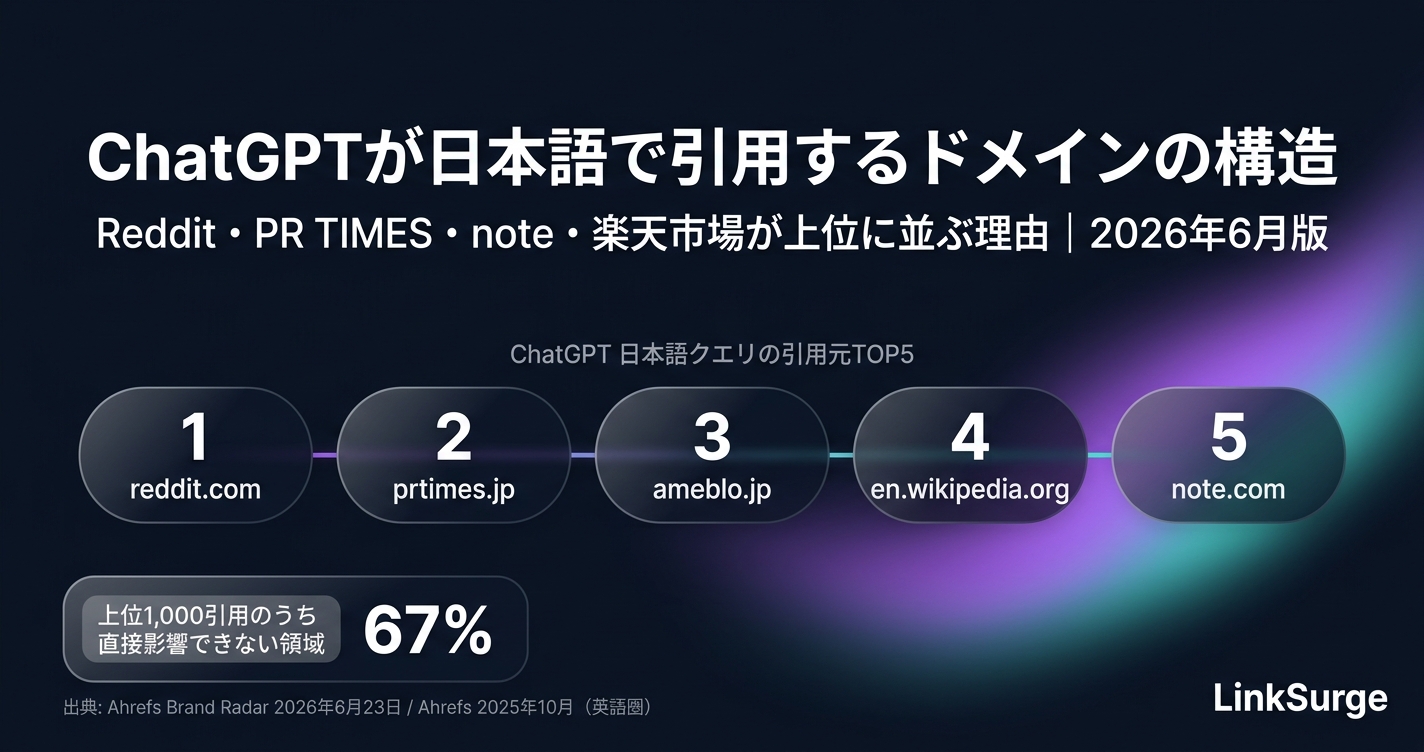
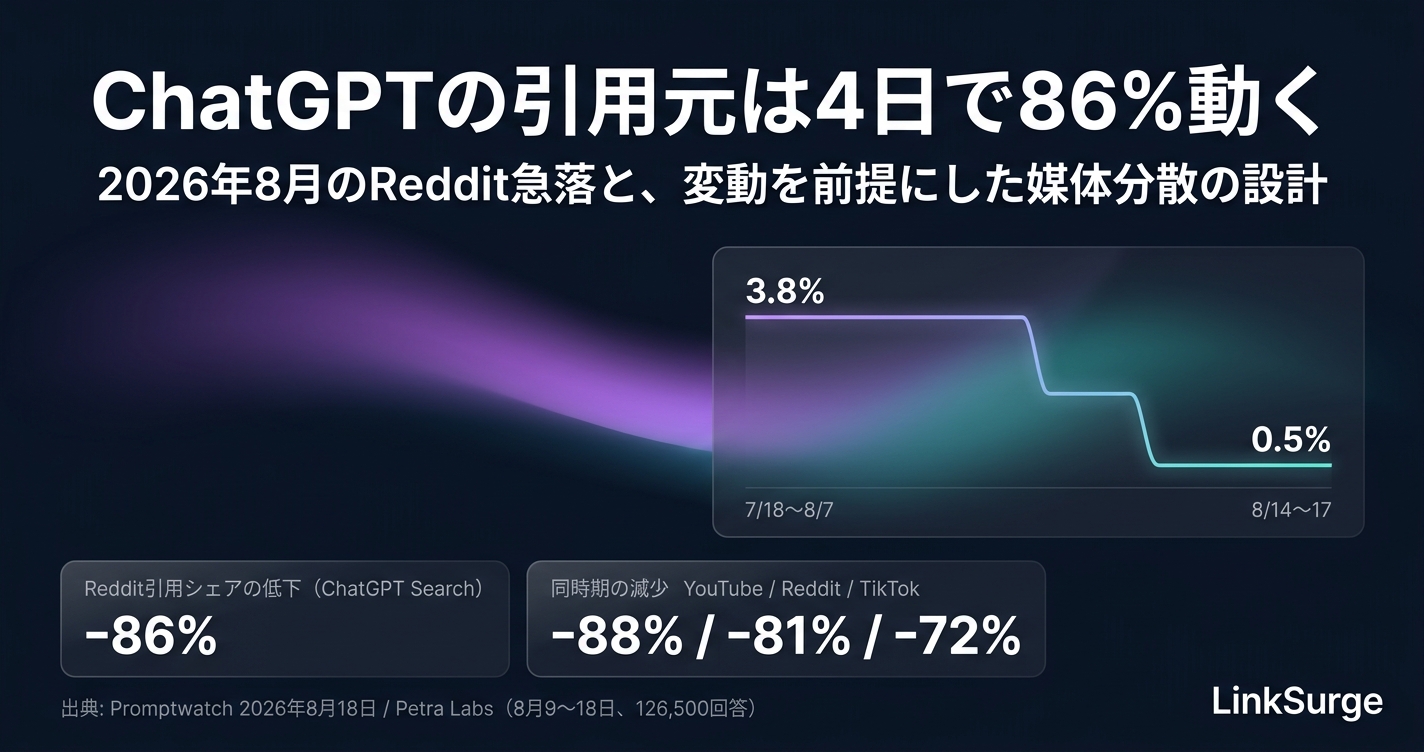
ChatGPTに特化した対策の全体像(三層インデックス・クローラー設定・日本語の引用元構造・計測)は「ChatGPTに引用される方法 完全ガイド2026」にまとめています。
SEOが「順位」から「順位+引用」へ移ってきた経緯は、「SEOはどう変わってきたか — キーワードを詰め込めば勝てた1990年代から、AIに引用される2026年まで」で30年の年表として整理しています。
参考・引用: LLMO - Large Language Model Optimization - Effective World What Is LLMO? Optimize Content for AI & Large Language Models - Search Engine Land
2. SEO・GEO・AIOとLLMOの違い
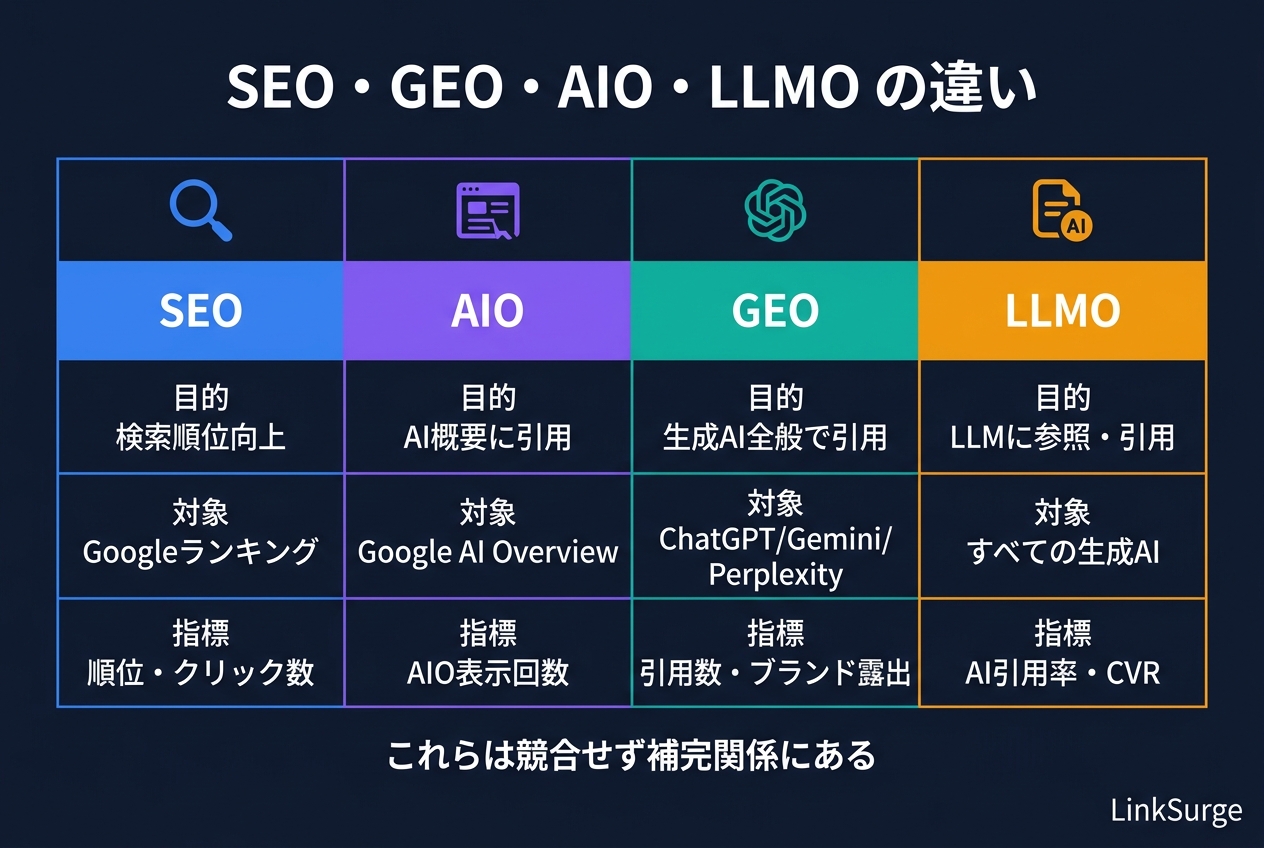
「LLMO、GEO、AIO、SEO…なんか似たような言葉が多くてよく分からない」というのは、私も最初に感じた疑問です。ここで整理してしまいましょう。
4つの概念の関係
SEO(検索エンジン最適化) は最もなじみ深い概念で、GoogleやYahoo!のような検索エンジンでの順位を上げてクリックを増やすことが目標です。ページの最適化、被リンク獲得、技術的なSEO設定などが中心施策です。
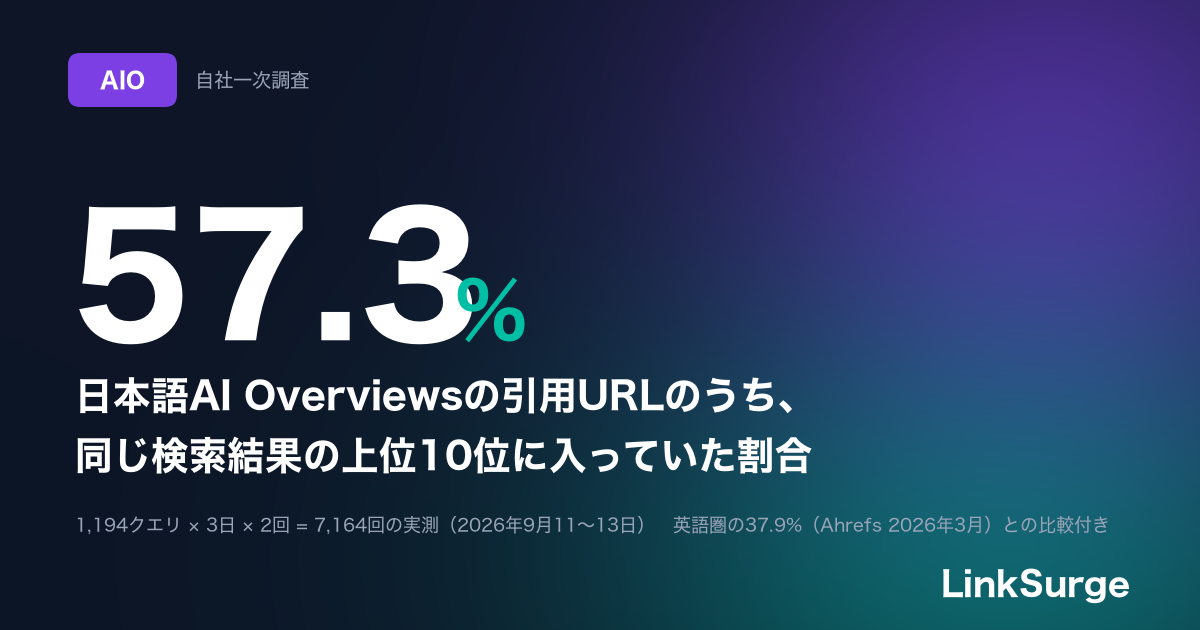
AIO(AI Overviews最適化) は、GoogleのAI Overview(以前のSGE)という機能に対する最適化です。検索結果の上部に表示されるAI生成の要約に自社コンテンツが引用されることを目指します。Google固有の取り組みです。
GEO(生成エンジン最適化) は、ChatGPT、Gemini、Perplexityなど複数の生成AIエンジン全体に対する最適化です。特定のプラットフォームに限らず、汎用的にAIに参照されるためのコンテンツ設計を指します。
LLMO(大規模言語モデル最適化) は、日本市場で広く使われている呼称で、GEOに最も近い概念です。「生成AI(LLM)に自社情報を参照させる」という実務領域全体を指します。
実際のところ、これら4つで使う技術は重複する部分が多く、「どれが正しい呼び方か」を議論するよりも、「AIに引用されるコンテンツを作る」という実務に集中した方が建設的です。
参考・引用: Large Language Model Optimization (LLMO) explained - Evergreen Media LLM Optimization vs Traditional SEO - SEONos
また、GEOの詳細な実践手法については生成エンジン最適化(GEO)完全ガイドで詳しく解説しています。
3. AIがコンテンツを参照する仕組み(RAGを理解する)
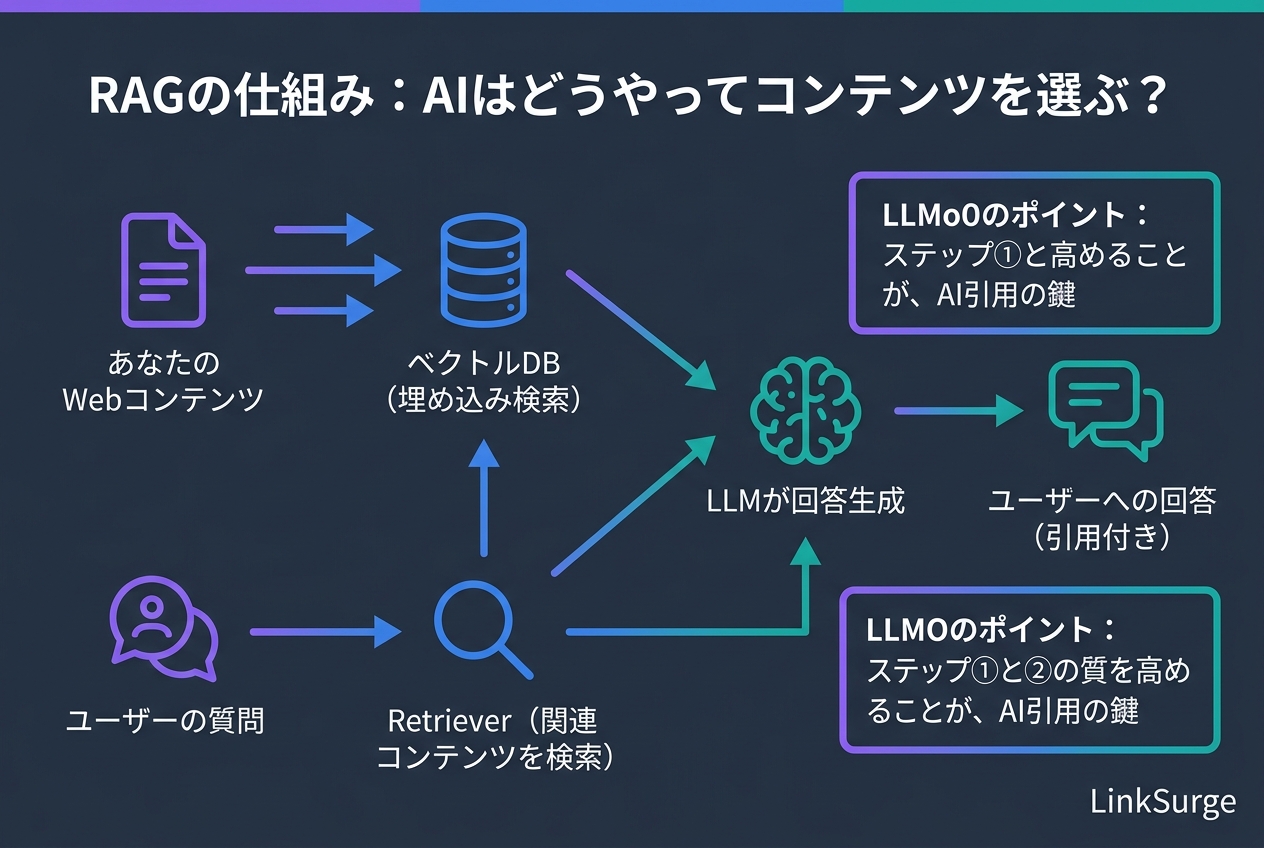
「なぜAIは特定のサイトの情報を引用し、他のサイトは引用しないのか?」
これを理解するためには、RAG(Retrieval-Augmented Generation、検索拡張生成) という技術を知る必要があります。RAGはLLMOを理解する上で最も重要な概念の一つです。
RAGの仕組み(超シンプル版)
- ユーザーが質問する → AIチャットに「おすすめのSEOツールは?」と入力
- AIが関連情報を検索する → ウェブ上の関連ドキュメントをベクトル検索でリトリーブ(取得)
- 取得した情報をプロンプトに組み込む → 「このコンテンツを参考にして回答してください」とAIに渡す
- AIが回答を生成する → 参照情報をもとに回答を作成し、引用を付与
つまり、AIは「すべてを自分の学習データから回答している」わけではなく、リアルタイムで外部のコンテンツを検索して参照しているケースが多いのです。
LLMOのポイントはまさにここにあります。 ステップ2で「検索されやすく」、ステップ3で「引用に値すると判断される」コンテンツを作ること。それがLLMOの本質です。
参考・引用: Retrieval Augmented Generation (RAG) for LLMs - PromptingGuide What is RAG (Retrieval-Augmented Generation)? - OpenAPI
LinkSurge
linksurge.jp
SEO・AIO・GEO統合分析プラットフォーム。AI Overviews分析、SEO順位計測、GEO引用最適化など、生成AI時代のブランド露出を最大化するための分析ツールを提供しています。
4. 今すぐできるLLMO実践チェックリスト
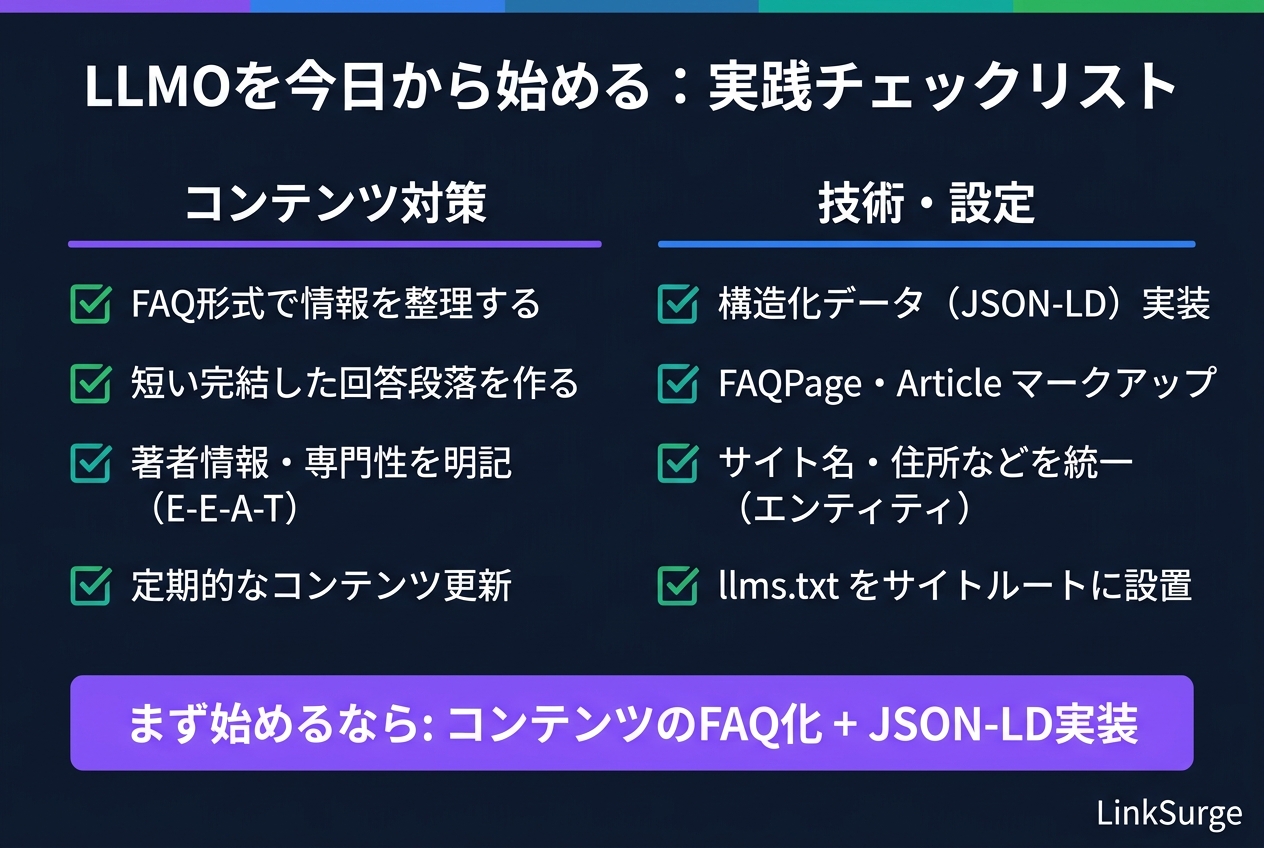
「理屈は分かった。では何をすればいい?」
Tavilyのリサーチレポートとの私自身の分析をもとに、初心者でも今すぐ着手できる施策を優先度順にまとめました。
コンテンツ対策(まずここから)
1. コンテンツをFAQ形式で整理する
「Q: LLMOとは何ですか? A: LLMOとは...」という形式で情報を整理すると、AIが「この質問への回答」として抽出しやすくなります。既存の記事のリライトから始めると効果的です。
2. 短く完結した「回答段落」を作る
1段落で完結する40〜60語程度の「Atomic Answer」を各セクションに配置しましょう。AIは長い文章から要点を抜き出すより、最初から完結した短い回答段落を引用する傾向があります。
3. 著者情報・専門性を明記する(E-E-A-T)
記事の著者名、肩書き、専門領域を明記することで、AIが「信頼できる情報源」と判断しやすくなります。医療・法律・金融など専門性が求められる分野では特に重要です。
4. 定期的にコンテンツを更新する
AIは新鮮な情報を優先的に参照する傾向があります。記事の更新日時を明記し、定期的に最新情報に更新しましょう。
技術・設定(次のステップ)
5. 構造化データ(JSON-LD)を実装する
FAQPage、Article、Productなどのschema.orgのマークアップをJSON-LDで実装すると、著者・公開日・商品情報といった対応関係が機械可読になります。
優先度は「最初にやること」ではありませんが、「やらなくていいもの」でもありません。 ここで多い誤読が、Googleの公式見解を「Googleは構造化データを使っていない」と受け取ってしまうことです。Googleが言っているのは「AI OverviewsやAI Modeに出るために追加の要件はなく、特別なschema.orgの構造化データを足す必要もない」ということで、これは対象になるための条件の話です。内部で参照していないという意味ではありません。
そのうえで、プラットフォームごとの扱いは次のように分かれます。
| プラットフォーム | 構造化データの扱い |
|---|---|
| Bing / Copilot | 公式に利用を明言。 MicrosoftのFabrice Canel氏(Principal Product Manager, Bing)がSMX Munichで「schemaはMicrosoftのLLMがコンテンツを理解する助けになる」と確認 |
| Google AI Overviews / AI Mode | 公式ドキュメントは「AI機能に出るための追加要件・特別なschemaは不要」。ただし不要=未使用ではない。Googleの構造化データ担当者が「fanout時にモデルへ渡すコンテキストとして使っている」と述べたとする二次報告(イベント参加者による記録。Googleの一次資料ではない)もある |
| Gemini | ある公開検証(1つのSaaSサイトを対象に2025年12月〜2026年3月に実施)では、7プラットフォーム中schemaの直接取得に成功したのはGeminiのみだった |
| ChatGPT / Perplexity | 同検証では直接取得に失敗。ただし別の検証では、ページのHTML全体をトークン化する経路でJSON-LDの中身がテキストとして読まれていることが示されている |
最後の行は軽視できません。別の公開検証では、可視コンテンツには一切書かれておらず、しかも意図的に壊したJSON-LDの中にだけ記載された架空の住所を、ChatGPTとPerplexityの両方が回答として出力しました。JSON-LDが読まれるかどうかは取得経路やクローラーによって変わりますが、読まれる経路が現に存在する以上、誤った内容を書けばそのまま誤答の原因になり得るということです。
つまり実務上の結論はこうなります。「AI引用を増やす施策」としては期待しない。ただし実装するなら内容は正確に保つ。 現時点で裏付けがあるのは、リッチリザルトなど従来の検索結果での見え方と、Bing/Copilotでの理解の補助です。なおGoogleは HowTo のリッチリザルトを2023年に、FAQPage のリッチリザルトを2026年5月に廃止しています(FAQPage)。リッチリザルト目的で残っているのは Article・BreadcrumbList などです(Product は商品ページ、Review は対象タイプに対する実際のレビュー・評価があるページに限られ、一般的な記事には使えません)。クローラー確認やコンテンツ整備を終えたあとの工程として扱ってください。
【2026年8月追記】 Googleは「AI OverviewsやAI Modeに出るために特別なschema.orgの構造化データを追加する必要はない」と公式に明言しています。schemaを追加した対照実験でも、AI Mode(+2.4%)とChatGPT(+2.2%)の変化はノイズと区別できず、引用の増加は確認されませんでした(AI Overviews は −4.6% で有意だが小さく、他要因の可能性あり)。 なお同実験の対象は、実験前からAI Overviewsに100回以上引用されていたページに限られます。 FAQPageが付くページは元々Q&Aとして整理されていることが多く、それが相関の数値に現れている可能性があります。ただしこの実験が検証したのはJSON-LDの追加であって、Q&A構成そのものの効果は測っていません。詳細は「「FAQスキーマで引用率3.2倍」は本当か — 自社の評価基準から未検証の数値を削除した話」で検証しています。
6. エンティティ情報を統一する
社名、住所、著者名などを全ページで一貫した表記にし、可能であればsameAsプロパティでWikipediaやLinkedInなどの外部ページとの関連を示しましょう。
7. llms.txtをサイトルートに設置する
llms.txtは、AIクローラー向けにサイトの重要ページやコンテンツの概要を伝えるためのファイルです。robots.txtのAI版のようなもので、まだ普及途上ですが設置のコストが低く試す価値があります。
注意: llms.txtの効果は2026年2月時点でまだ立証されていないとの報告もあります。他の施策と並行して取り組むのが賢明です。
【2026年8月追記】 その後Googleは公式に「Google Searchでは使わない」と明言しました。一方でAnthropicなどが自社ドキュメントで公開しており、AIエージェント用途では実際に使われています。 検索での引用とエージェントへの提供は目的が違うため、分けて判断してください。詳細は「「FAQスキーマで引用率3.2倍」は本当か — 自社の評価基準から未検証の数値を削除した話」で整理しています。
AIがあなたのサイトをどう認識しているか気になる方は、LinkSurgeのGEO分析ツールでChatGPT・Gemini・Perplexityでの引用状況を確認できます。
参考・引用: Answer Engine Optimization (AEO): The 2026 Guide - LLMRefs What Is LLM Optimization? Key Benefits & Definitions - Conductor AI features and your website - Google Search Central(AI機能に追加要件・特別なschemaは不要とするGoogle公式ドキュメント) Microsoft Bing/Copilot use schema for its LLMs - Search Engine Land(Bing/Copilotがschemaを利用していることの公式確認) Schema Markup and AI Search: What a 3-Month Study Revealed - Otterly.AI(1サイトを対象に2025年12月〜2026年3月に実施された7プラットフォームの取得検証。成功したのはGeminiのみ) The Three Lives of Schema Markup - Suganthan Mohanadasan(LLMがJSON-LDをテキストとして扱う仕組みの整理)
AI検索全般の最新動向については生成AI検索がSEOを変える:AI Overviews・AI Modeの最新動向と7つの実践対策も参考にしてください。
5. LLMOの効果を測定する方法
LLMOを実施したあと、「本当に効果が出ているのか」をどう確認すればいいでしょうか?従来のSEOとは異なり、LLMOは専用の指標で測る必要があります。
主要なKPI
AI引用数・引用頻度
ChatGPT、Gemini、Perplexityなどで自社ドメインやブランド名がどれだけ言及・引用されているかを定期的にモニタリングします。
AI由来のトラフィック
Googleアナリティクスのリファラーデータでai.google.com、chatgpt.com、perplexity.aiからのアクセス数を確認します。
AI経由のコンバージョン率(CVR)
調査によると、AI検索経由で訪問したユーザーは従来の検索経由ユーザーよりコンバージョン率が高い傾向があります。AI由来セグメントのCVRを別途測定してみると興味深い結果が出るかもしれません。
ブランド表示・推薦率
「〇〇(自社の商品・サービス名)でおすすめは?」とAIに質問したとき、自社が推薦されるかどうかを定期的に確認します。
LinkSurgeのLLMメンション分析では、主要AIエンジンでの自社ブランドの引用状況を定量的に把握できます。
参考・引用: LLM Optimization vs. Traditional SEO: Key Difference - ResultFirst
こうした最適化の指針が実際のデータで裏付けられるかを検証した記録が「AI検索は記事のどこを引用するのか」です。よく言われる「冒頭に結論を置け」がどこまで正しいのかを、実引用277件で確かめています。
よくある質問(FAQ)
LLMOとGEOは同じものですか?
ほぼ同じ概念です。GEO(Generative Engine Optimization)は英語圏で一般的な呼称で、LLMO(Large Language Model Optimization)は日本市場でよく使われます。どちらも「生成AIに引用されるための最適化」を指しますが、強調点の差があります。GEOは複数の生成エンジン全体への最適化を、LLMOはLLM(大規模言語モデル)という技術層への最適化を意識した呼び方です。
既存のSEOを止めてLLMOに移行すべきですか?
いいえ、SEOを止める必要はありません。Googleの検索経由のトラフィックはまだ多数を占めており、SEOの効果は現在も続いています。LLMOはSEOに「加えて」行うものです。多くのLLMO施策(良質なコンテンツ、構造化データ、E-E-A-T強化)は、実はSEOにも良い影響を与えます。
llms.txtは必ず設置すべきですか?
llms.txtは設置コストが低いので、試してみる価値はあります。ただし、2026年時点でllms.txtを設置することでAI引用が増えるという科学的な立証はまだされていません。必須施策というよりは「将来への投資」として位置づけるのが現実的です。優先度は、狙うサービスのクローラー(Googleなら Googlebot、ChatGPTの検索なら OAI-SearchBot)が通っているかの確認が上です。コンテンツのFAQ化は取り組む価値がありますが、引用が増えるという効果自体は検証されていない点にご留意ください。
構造化データ(JSON-LD)は結局必要ですか?
AI引用を増やす目的なら必須ではありません。 Googleは「AI OverviewsやAI Modeに出るために追加の要件はなく、特別なschema.orgの構造化データを足す必要もない」と公式に明言しており、schemaを追加した対照実験でもAI引用の増加は確認されていません。ただしこれは「出るための追加要件ではない」という意味であって、Googleが内部で参照していないという意味ではない点に注意してください。そのうえで、別の用途では有用です。MicrosoftはBing/Copilotのモデルがschemaを利用していることを公式に認めており、リッチリザルトなど従来の検索結果での見え方にも効きます(ただし FAQPage と HowTo のリッチリザルトは廃止済みです)。また1サイトを対象にした公開検証では、7プラットフォーム中Geminiのみがschemaの直接取得に成功しました。ChatGPTやPerplexityはこの検証では直接取得に失敗していますが、別の検証ではJSON-LDの中身がテキストとして読まれることが示されており、読まれるかどうかは取得経路によって変わります。読まれる経路が存在する以上、記述の正確さ自体が意味を持ちます。まとめると、優先度は高くないが、やる価値はある。クローラー確認やコンテンツ整備を終えたあとに、可視コンテンツと矛盾しない正確な内容で実装するのが現実的です。
費用はどのくらいかかりますか?
基本的なLLMO施策(コンテンツ整備、構造化データ、llms.txt設置)は特別な費用はかかりません。ツール類もオープンソースやフリーミアムのものが多数あります。費用がかかるのは、本格的なRAGシステムの構築やAI引用のモニタリングツールを使う場合です。
効果が出るまでどのくらいかかりますか?
AIの学習データはリアルタイムでは更新されないため、施策の効果が反映されるまで数週間から数か月かかる場合があります。ただし、Perplexityのようにリアルタイム検索を行うAIでは、コンテンツ更新後比較的すぐに影響が出ることもあります。
まとめ:LLMOは「AIと共存するWebコンテンツ戦略」
生成AIが検索行動を変えている今、「Googleで上位表示される」だけが目標では十分ではなくなってきています。ChatGPT、Gemini、Perplexityといった生成AIに自社コンテンツが引用・参照されることが、新しい時代のブランド露出の形になっています。
とはいえ、LLMOは難しいものではありません。良質で構造化されたコンテンツを作り、著者情報・エンティティを整備し、構造化データを実装する——これはSEOで当たり前にやってきたことの延長線上にあります。
まず始めるなら、狙うサービスのクローラーが通っているかの確認から取り組んでください。ここは必要条件なので、最初に潰す価値があります。
クローラーはサービスごとに違います。Google AI Overviews / AI Mode なら Googlebot、ChatGPTの検索なら OAI-SearchBot、Perplexity なら PerplexityBot、Claude なら Claude-SearchBot です。GPTBot はモデル学習用、Google-Extended は Gemini Apps 向けで、いずれも検索での引用には効きません。 また通すことは読み取ってもらうための必要条件であって、引用を保証するものではありません。
そのうえで、既存記事のFAQ化は取り組む価値のある候補です。ただし「FAQ化すると引用が増える」という効果は、現時点で検証されていません(対照実験が測ったのはJSON-LDの追加であり、Q&A構成そのものの効果は測っていない)。自社で効果を確かめながら進めてください。
JSON-LDの実装は、この2つの後で構いません。ただし「やらない」ではなく「後回し」です。 Bing/Copilotは公式に利用を明言しており、公開検証ではGeminiが取得に成功しています。JSON-LDが読まれるかどうかは取得経路によって変わりますが、読まれる経路は現に存在します。実装するときは、可視コンテンツと食い違わない正確な内容にしてください(2026-08 更新)。
LinkSurgeではGEO分析ツールやLLMメンション分析を通じて、生成AI時代のブランド露出を包括的に分析・最適化するためのツールを提供しています。ぜひ活用してみてください。